
昨天盤點了 PokeThreads 的攻擊面,列出幾個明確的缺口:擋不住分散式的爬蟲與洗版、看不懂檔案內容、管不到內部服務之間的信任、也完全沒有「這個人能不能做這件事」的概念。
今天把這些缺口一個一個補上。
昨天提到 Rate Limiter 工作在應用層,很多攻擊卻在更早的階段就該被擋下。WAF(Web Application Firewall) 就是補這一段空隙的角色,它站在 Load Balancer 前面(或整合在其中),專門辨識已知的攻擊特徵,包括:
WAF 的特性是規則導向:比對的是「已知的攻擊長什麼樣子」。
所以 WAF 對於新型態、還沒被寫進規則庫的攻擊就防護力有限,但光是擋掉大量已知攻擊手法,就能讓後面每一層省下不少負擔,這是它存在的意義。
這一段不重新推導,只做個總結,Authentication(AuthN,身份驗證——你是誰)這部分從 Day 2 就開始討論:
「使用者是誰」這件事目前已有一套可 Horizontal Scaling 的做法。
前面 AuthN 回答的是「你是誰」。
Authorization(AuthZ,權限控管)回答的是「你能做什麼」,這是目前系統裡完全沒處理過的一塊。
舉個具體例子:Charmander 登入之後,理論上通過了 AuthN 這一關,如果他對著 DELETE /posts/456 發出 Request,而 456 其實是 Pikachu 發的貼文,系統該怎麼反應?
如果只檢查「這個 Request 有沒有帶合法的 Session/Token」,Charmander 會直接刪掉 Pikachu 的貼文,因為系統只確認了「你有登入」,卻沒確認「你有沒有權限動這篇貼文」。
最簡單的做法是 Ownership-based 檢查,在執行刪除前,多一道判斷「發出 Request 的人,是不是這篇貼文的作者,或是 Admin」。
規模再大一點,通常會走向 RBAC(Role-Based Access Control),把權限跟角色綁在一起,而不是每個操作都寫死判斷邏輯:
USER、MODERATOR、ADMIN,有的系統還有 SUPER_ADMIN
之後任何「能不能做某件事」的判斷,都可以統一問:「這個 User 的 Role,有沒有被授權執行這個操作」,而不是在程式碼裡到處散落零散的 if user.id == post.author_id。
Authorization 這層應該放在 Backend Service 內部(拿到 Request 之後、真正執行操作之前),而不是丟給 Day 14 的 API Gateway。
Gateway 知道「這是誰」,但通常不會知道每個 Service 內部具體的權限規則,那是各個 Service 自己該負責的事。
回到 Day 28 提到的問題,如果攻擊者把爬蟲/洗版流量分散到大量不同來源,讓每個來源看起來都「沒超過限制」,Rate Limiter 自然就失效了。
這需要更聰明的偵測邏輯,而不只是單純數 Request 次數:
這幾年「行為異常偵測」這件事,很大程度已經交給機器學習模型負責,而不是寫死一條條規則。
做法上通常是把使用者過去的行為(發文頻率、按讚模式、裝置指紋、瀏覽路徑等等)餵給模型,讓它輸出一個「這個行為像不像機器人」的分數(Bot Score),而不是簡單的「超過某個數字就擋」。
這樣的好處是能捕捉到規則寫不完、也還沒被定義過的異常模式,比較能適應攻擊手法一直在變化的現實,這跟前面 WAF 的規則導向剛好形成對比:
WAF 和 AI 兩者互補。
這些機制通常會需要前面各層蒐集到的資料,也就是 Day 25 的 Observability 建立的 Logging/Metrics,這些元件正好是偵測「異常模式」所需要的原始資料來源。
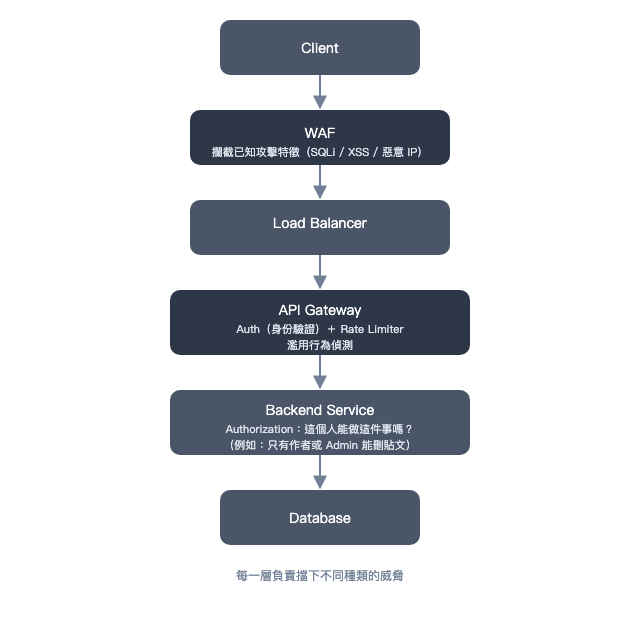
把今天補上的東西疊起來,一個 Request 要真正碰到 Database 之前,會依序經過:
Client
  ↓
WAF(擋已知攻擊特徵)
  ↓
Load Balancer
  ↓
API Gateway(Auth + Rate Limiter + 濫用偵測)
  ↓
Backend Service(Authorization:這個人能做這件事嗎?)
  ↓
Database
沒有任何一層是萬能的,WAF 擋不住合法帳號的濫用行為,Rate Limiter 擋不住分散式的慢速攻擊,Authorization 管不到「還沒登入就發生」的問題。
資安防護不是一道完美的牆,而是讓每一層各自負責最擅長的那一種風險,疊加起來才夠紮實。
今天把 Day 28 找出的缺口逐一補上:
這個系列一路把 PokeThreads 從一台 Server 做到今天,資安內容卻是第 28、29 天才認真討論,現實中絕對不能這樣搞。
在實務上,這些考量理想上應該從一開始就融入每個設計決策,而不是蓋完系統才回頭補防護,但作為一個系統設計的入門系列,先把系統做出來、理解它怎麼運作,再回頭看它哪裡會被攻破,我自己覺得是一種合理的學習順序啦,畢竟很多人對資安議題就是沒興趣 😅。
明天是這個系列的最後一篇,該回頭看看,這一路是怎麼從一台最陽春的 Server,走到今天這個樣子的。


 iThome鐵人賽
 看影片追技術